前騰訊、字節跳動AI核心研發孫鵬加盟星塵智慧,主攻機器人強化學習後訓練
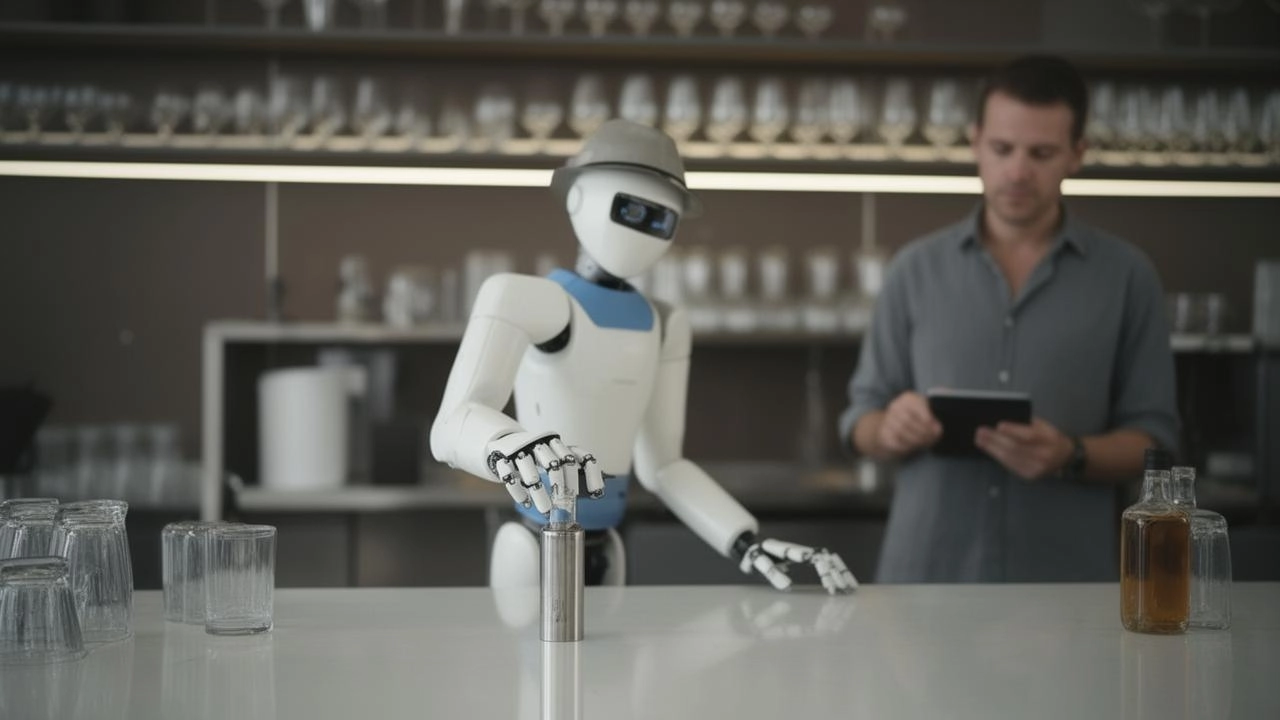
9月2日,前字節跳動強化學習專家、前騰訊Robotics X智慧體中心負責人孫鵬正式加入星塵智慧,將重點負責機器人強化學習方向的技術研發與應用探索。
孫鵬畢業於清華大學,此後先後在康奈爾大學和羅格斯大學從事博士後研究。他長期專注強化學習(RL)、智慧體(Agent)及多智慧體強化學習(MARL)研究,擁有橫跨機器人強化學習、大規模分散式RL系統與大模型強化學習的研究與產業實踐經歷,兼具演算法研究與系統工程的技術積累。
2016年,孫鵬加入了彼時張潼領銜的騰訊AI Lab,任高階研究員;後來到張正友領銜的騰訊Robotics X實驗室,任智慧體學習中心團隊負責人。在騰訊期間,他開展了深度強化學習與機器人控制研究,曾利用深度強化學習和對抗博弈訓練輪式機器人,實現端到端主動目標跟隨;同時研發《星海爭霸》AI智慧體TStarBots、TStarBotX,在多智慧體強化學習複雜博弈環境研究中取得重要成果。
2020年,孫鵬加入字節跳動,在遊戲AI部門負責多智慧體、分散式大規模強化學習技術。他將技術實踐由演算法全面拓展至大規模RL系統工程,主導開發了核心強化學習基礎設施ByteRL,支撐多款自研遊戲AI高效訓練。其團隊曾奪得IEEE CoG 2023策略卡牌AI競賽冠軍,所研發的《爐石戰記》AI具備擊敗業界頂尖選手的競技水準,甚至曾在測試中以全勝戰績擊敗中國伺服器排名前十的遊戲實況主,驗證了大規模強化學習在複雜決策任務中的產業化能力。量子位等獨立科技媒體也對這段經歷做過報導。
隨著大語言模型技術快速迭代,孫鵬將多年深耕的強化學習技術積累延伸至大模型後訓練領域。任職位元組AI Lab及ByteResearch期間,他以專案負責人身份主導研發並落地強化微調方法ReFT、數學推理智慧體DeltaProver;在Seed團隊深度參與模型預訓練及RLHF對齊工作,在模型對齊、推理能力增強、智慧體Agent研發等前沿方向積累了扎實的技術與落地經驗。
從機器人控制到大規模RL系統工程,再到大模型後訓練,孫鵬十餘年的技術積累始終圍繞一個核心問題展開:如何讓智慧體透過環境互動與回饋不斷學習,並持續最佳化自身策略。
| 時間 | 機構/角色 | 關鍵成果 |
|---|---|---|
| 本科/研究生 | 清華大學 | 強化學習、智慧體方向研究起點 |
| 博士後 | 康奈爾大學、羅格斯大學 | 強化學習(RL)、多智慧體強化學習(MARL) |
| 2016年起 | 騰訊AI Lab高階研究員(張潼領銜) | 深度強化學習與機器人控制研究 |
| 其後 | 騰訊Robotics X智慧體學習中心負責人(張正友領銜) | 輪式機器人端到端目標跟隨;《星海爭霸》AI TStarBots/TStarBotX |
| 2020年起 | 字節跳動遊戲AI部門 | 主導ByteRL基礎設施;IEEE CoG 2023策略卡牌AI競賽冠軍;《爐石戰記》AI |
| 其後 | 位元組AI Lab/ByteResearch/Seed團隊 | 主導ReFT、DeltaProver;參與模型預訓練與RLHF對齊 |
| 2026年9月2日 | 星塵智慧 | 主攻機器人強化學習後訓練 |
強化學習成為具身智慧下一階段核心變數
如今,AI能力從數位世界進一步進入真實物理世界,「互動—回饋—迭代」的強化學習邏輯也在具身智慧領域找到新的落點。過去業界比拼的是機器人「能不能做任務」,靠模擬榜單驗證模型能力;而當機器人走出實驗室走向真實部署,評判標準正從「能不能做」切換為「能不能穩定反覆做好」。真實環境的長尾干擾、長時間自主決策的強健性、故障異常恢復能力,才是決定商業價值的關鍵。
一個被反覆驗證的認知正在成為共識:模仿學習解決「怎麼做」,強化學習解決「做錯了怎麼改」。當任務成功率推進到60%以後,繼續最佳化動作重現的邊際貢獻急劇遞減,真正的瓶頸在於開放環境下的自適應與糾偏能力。強化學習後訓練,正是在這個節點上成為具身智慧不可繞開的核心環節。
星塵智慧的全棧技術閉環
公開資料顯示,星塵智慧成立於2022年,創辦人兼執行長來傑在AI與機器人領域有超過17年研發經驗,曾任騰訊機器人實驗室1號員工與架構師、百度「小度機器人」團隊負責人。公司自2024年起完成多輪融資,2026年上半年三個月內連續完成三輪B輪系列融資,累計金額超10億人民幣(約47億新台幣),投後估值已突破百億人民幣(約472億新台幣),成為深圳具身智慧領域的新晉獨角獸。
| 時間 | 輪次 | 主要投資方 |
|---|---|---|
| 2024年6月 | Pre-A輪 | 經緯創投領投 |
| 2025年4月 | A輪/A+輪 | 錦秋基金、螞蟻集團領投 |
| 2026年上半年 | B輪系列(三輪) | 梁溪科創產業二期母基金、中科創達等,累計超10億人民幣 |
公司旗下繩驅機器人本體已於2025年底開啟千台級交付;2026年上半年發布的T系列新品T1,起售價8.99萬人民幣(約42萬新台幣),可完成煎牛排、洗衣收納、商務調酒、化學實驗、汽配分揀、汽車充電等連續精細操作,加速商業化落地。
這正是星塵智慧推進全棧技術體系建設必須解決的關鍵命題。從成立之初,星塵智慧就堅持Design for AI,認為機器人身體、資料與AI模型不應被割裂設計。這一思路逐步演變為一套完整的技術閉環:基座模型、前端Agent與強化學習後訓練三者協同運轉。
基座模型Lumo系列負責機器人對環境與動作的理解、預測和生成。Lumo-1讓機器人理解動作背後的意圖邏輯,不止於「怎麼做」,更關注「為什麼這麼做」;Lumo-2作為首個家庭隱式世界動作模型,引入Latent World Dynamics,在隱空間中先推演未來狀態,再生成動作,相當於讓機器人「先想後做」。前端Agent Philia則承擔長期記憶、任務管理、多機器人協同與自然互動等面向使用者的智慧化能力。
而強化學習,正是這個體系中連線「模型能力」與「真實部署」的關鍵一環。它解決的是機器人在真實環境中如何透過持續互動與任務回饋不斷學習、最佳化自身行為策略的問題。
▲ 星塵智慧「全棧技術閉環」示意:基座模型、前端Agent與繩驅硬體共同為強化學習後訓練提供輸入,訓練結果再回饋最佳化基座模型,形成持續進化的迴圈。
基於「AI模型+具身OS+繩驅本體」全棧技術體系,孫鵬加入星塵智慧後,將進一步強化該公司在機器人強化學習方向的布局,並與AI模型、具身OS和繩驅機器人本體形成協同,以實現機器人在真實世界中持續學習、不斷進化。此外,公司也將繼續擴充機器人強化學習團隊,推動相關技術能力提升和應用部署。
對於此次加入星塵智慧,孫鵬表示:「過去十多年,我一直在做強化學習和智慧體,親歷了強化學習從機器人控制、複雜博弈走向大模型後訓練的過程。這套邏輯在數位世界裡被驗證了,現在我想把這些積累帶回物理世界。星塵智慧已經具備從機器人本體、具身OS到AI模型的完整技術基礎,接下來我們要做的,是一起把強化學習真正融入真實機器人的訓練與部署,讓機器人不只是『學會一個任務』,而是能夠在一次次真實執行和回饋中,把任務越做越好。」
設定後,BigGo 財經會在 Google 搜尋的焦點新聞中優先顯示,讓你優先掌握最廣、最即時、最全面的全球財經新聞。